Apache Airflow는 배치 기반 데이터 파이프라인, 머신러닝 모델 학습, 에이전틱 및 LLM 기반 워크로드와 같은 워크플로우를 개발하고, 스케줄링하고, 모니터링하기 위한 오픈소스 플랫폼입니다. Airbnb에서 처음 만들어진 이후 Apache 소프트웨어 재단의 톱레벨 프로젝트가 되었고, 지금은 데이터 엔지니어링 분야에서 사실상의 표준 오케스트레이션 도구로 자리잡았습니다.
Airflow의 핵심 철학은 “Workflows as Code“입니다. 워크플로우가 전적으로 Python 코드로 정의되기 때문에, 다음과 같은 이점을 얻을 수 있습니다.
- 동적(Dynamic): 파이프라인이 코드로 정의되기 때문에 동적인 DAG 생성과 파라미터화가 가능합니다.
- 확장성(Extensible): 다양한 내장 오퍼레이터를 제공하며, 필요에 맞게 프레임워크 자체를 확장할 수 있습니다.
- 유연성(Flexible): Jinja 템플릿 엔진을 활용해 풍부한 커스터마이징이 가능합니다.
즉, GUI 클릭으로 파이프라인을 구성하는 ETL 툴과 달리, 엔지니어가 익숙한 Python 코드와 Git 워크플로우(버전 관리, 코드 리뷰, 테스트, CI/CD)를 그대로 데이터 파이프라인 개발에 적용할 수 있다는 점이 Airflow의 가장 큰 강점입니다. Airflow는 사실상 코드로 실행할 수 있는 모든 것을 오케스트레이션할 수 있으며, 웹 기반 UI를 통해 워크플로우의 시각화·관리·디버깅을 지원하고, 노트북 위의 단일 프로세스부터 대규모 워크로드를 처리하는 분산 시스템까지 다양한 구성으로 실행할 수 있습니다.
반대로, 클릭 기반의 작업 방식을 선호한다면 Airflow는 적합하지 않을 수 있습니다. UI가 워크플로우 관리를 단순화해주긴 하지만, 코드로 워크플로우를 정의하는 것이 Airflow 작동 방식의 핵심이기 때문에 항상 어느 정도의 코딩이 필요합니다. 즉, “정해진 시작과 끝이 있고 스케줄에 따라 실행되는” 배치성 워크플로우에는 최적이지만, 완전한 실시간 스트리밍 처리에는 적합하지 않습니다.
아키텍처 및 주요 구조 설명
Architecture Overview
Airflow는 워크플로우를 DAG(Directed Acyclic Graph, 방향성 비순환 그래프)로 표현하며, DAG는 의존성과 데이터 흐름을 고려해 배치된 개별 작업 단위인 Task들로 구성됩니다. DAG는 태스크 간의 의존성을 명시하여 태스크가 실행되는 순서를 정의하고, 태스크는 데이터 수집, 분석 실행, 다른 시스템 트리거 등 실제로 무엇을 할지를 기술합니다.
필수 컴포넌트(Required Components)
최소 구성의 Airflow는 아래 요소들로 이루어집니다.
- Scheduler(스케줄러): 스케줄된 워크플로우를 트리거하고, 태스크를 Executor에 제출해 실행시키는 역할을 담당합니다. Executor는 별도 컴포넌트가 아니라 스케줄러의 설정 속성이며 스케줄러 프로세스 내부에서 동작합니다.
- Dag Processor(DAG 프로세서): DAG 번들에서 DAG 파일을 파싱해 메타데이터 데이터베이스에 직렬화(serialize)합니다.
- Dag Bundle(DAG 번들): DAG 프로세서가 DAG 파일을 읽어오는 소스이며, 기본적으로는 로컬 디스크의 폴더입니다(Git 등 버전 관리 백엔드로 대체 가능).
- API Server: REST API를 제공하고 DAG·태스크의 동작을 검사·트리거·디버깅할 수 있는 UI를 제공하며, Task SDK를 사용하는 태스크가 메타데이터 DB에 직접 접근하지 않고 상태를 되돌려 보낼 때도 사용됩니다.
- Metadata Database(메타데이터 DB): 보통 PostgreSQL이나 MySQL을 사용하며, 태스크·DAG·변수의 상태를 저장합니다.
선택 컴포넌트(Optional Components)
- Worker: 스케줄러가 넘겨준 태스크를 실제로 실행하며, CeleryExecutor에서는 장기 실행 프로세스로, KubernetesExecutor에서는 하나의 Pod로 동작할 수 있습니다.
- Triggerer: asyncio 이벤트 루프에서 지연(deferred)된 태스크를 실행하는 역할을 하며, deferrable 오퍼레이터를 쓰지 않는 기본 설치에서는 필요하지 않습니다.
- Plugins: Airflow의 기능을 확장하는 설치 패키지와 유사한 개념으로, 스케줄러·DAG 프로세서·트리거러·API 서버에서 읽힙니다.
배포 방식도 단계적으로 확장됩니다. 한 대의 머신에서 스케줄러와 워커가 같은 파이썬 프로세스로 동작하는 LocalExecutor 기반의 단일 머신 배포부터, 각 컴포넌트가 여러 머신에 분산되고 Deployment Manager·DAG 작성자·운영 사용자 등 역할이 분리되는 분산 아키텍처까지 확장할 수 있습니다. 특히 Airflow 3부터는 DAG 프로세서가 모든 배포에서 독립 프로세스로 항상 실행되어, 스케줄러가 DAG 번들에 직접 접근하지 못하게 함으로써 DAG 작성자가 제출한 코드가 스케줄러 컨텍스트에서 절대 실행되지 않도록 보장합니다. 이는 보안 및 멀티테넌시 관점에서 중요한 설계 변화입니다.
태스크 실행 측면에서 워커는 태스크 코드를 자신의 프로세스 안에서 직접 실행하지 않고, 태스크 인스턴스마다 새로운 서브프로세스를 생성·감독·종료합니다. Python이면 포크된 인터프리터, Java면 새로운 JVM 인스턴스, Go면 새로운 컴파일 바이너리 프로세스가 생성되며, 아무 것도 재사용되지 않기 때문에 동시 실행되는 태스크 수만큼 리소스를 산정해야 합니다.
주요 구성 요소 및 개념
| 개념 | 설명 |
|---|---|
| DAG | 워크플로우 전체를 캡슐화하는 모델. 스케줄, 태스크, 태스크 의존성, 콜백 등 운영에 필요한 세부 정보를 속성으로 포함합니다. |
| DAG Run | 특정 데이터 구간(data interval)에 대해 실행되는 DAG의 한 번의 인스턴스. 그리드 뷰의 한 열이 하나의 DAG Run에 해당합니다. |
| Task | DAG를 구성하는 최소 작업 단위. 실행 시점에 Task Instance가 되어 상태(성공/실패/재시도 등)를 갖습니다. |
| Operator | DAG를 빠르게 구성할 수 있도록 미리 정의된 태스크 템플릿으로, BashOperator, PythonOperator처럼 특정 작업을 수행하도록 이미 구현되어 있습니다. |
| Sensor | 오퍼레이터의 특수한 하위 클래스로, 외부 이벤트가 발생하기를 기다리는 역할에 특화되어 있습니다(파일 도착 대기, 외부 API 상태 확인 등). |
| TaskFlow | @task 데코레이터로 일반 Python 함수를 태스크로 패키징하는 최신 문법으로, 함수 간 반환값이 자동으로 XCom을 통해 전달됩니다. |
| Executor | 스케줄러의 설정 속성으로서, 태스크를 어떻게(어디서) 실행할지를 결정합니다(LocalExecutor, CeleryExecutor, KubernetesExecutor 등). |
| XCom | 태스크 간에 작은 메타데이터를 주고받는(“Cross-communication”) 메커니즘입니다. |
Operator/Sensor/TaskFlow는 개념적으로 서로 다르지만, 내부적으로는 모두 Airflow의 BaseOperator를 상속한 서브클래스이며, Operator를 DAG 파일 안에서 호출하는 순간 그것이 하나의 Task가 됩니다. 실제 코드는 다음과 같은 형태를 띱니다.
from datetime import datetime
from airflow.sdk import DAG, task
from airflow.providers.standard.operators.bash import BashOperator

with DAG(dag_id="demo", start_date=datetime(2022, 1, 1), schedule="0 0 * * *"):
    hello = BashOperator(task_id="hello", bash_command="echo hello")

    @task.bash
    def airflow():
        return "echo airflow"

    @task
    def world():
        print("world")

    hello >> airflow() >> world()
위 코드는 매일 자정에 실행되도록 스케줄된 “demo”라는 DAG를 정의하며, BashOperator와 @task.bash 데코레이터로 각각 셸 스크립트를 실행하는 두 개의 Bash 태스크, 그리고 @task 데코레이터로 Python 함수를 실행하는 태스크 하나로 구성됩니다. >> 연산자는 실행 순서(의존성)를 정의합니다.
태스크 간 의존성은 >>, << 연산자 혹은 set_upstream/set_downstream 메서드로 정의할 수 있으며, 기본적으로 태스크는 모든 상위(upstream) 태스크가 성공할 때까지 대기하지만, Branching·LatestOnly·Trigger Rule 같은 기능으로 이 동작을 커스터마이징할 수 있습니다. 데이터 전달은 XCom, 외부 스토리지 서비스 업/다운로드, 혹은 TaskFlow API가 암묵적으로 처리하는 XCom 전달 세 가지 방식으로 이루어집니다.
설치 및 사용 방법
가장 빠르게 시작하는 방법은 airflow standalone 명령으로, 이는 데이터베이스를 초기화하고, 사용자를 생성하고, 모든 컴포넌트를 한 번에 실행해주는 올인원 명령입니다.
# 1) Airflow 홈 디렉터리 지정 (선택)
export AIRFLOW_HOME=~/airflow

# 2) 가상환경 생성 및 활성화 (uv 사용 예)
python3 -m venv airflow_venv
source airflow_venv/bin/activate

# 3) 버전에 맞는 제약(constraint) 파일을 사용해 설치
AIRFLOW_VERSION=3.1.1
PYTHON_VERSION="$(python -c 'import sys; print(f"{sys.version_info.major}.{sys.version_info.minor}")')"
CONSTRAINT_URL="https://raw.githubusercontent.com/apache/airflow/constraints-${AIRFLOW_VERSION}/constraints-${PYTHON_VERSION}.txt"
pip install "apache-airflow==${AIRFLOW_VERSION}" --constraint "${CONSTRAINT_URL}"

# 4) 모든 컴포넌트 한 번에 기동
airflow standalone
Airflow 3.x부터는 standalone 실행 시 관리자 비밀번호가 터미널에 표시되지 않을 수 있으며, $AIRFLOW_HOME/simple_auth_manager_passwords.json.generated 파일에 저장되므로 아래 명령으로 확인합니다.
cat ~/airflow/simple_auth_manager_passwords.json.generated
이후 브라우저에서 localhost:8080에 접속해 터미널에 표시된 관리자 계정으로 로그인하고, 홈 화면에서 example_bash_operator DAG를 활성화하면 첫 예제 파이프라인을 실행해볼 수 있습니다.
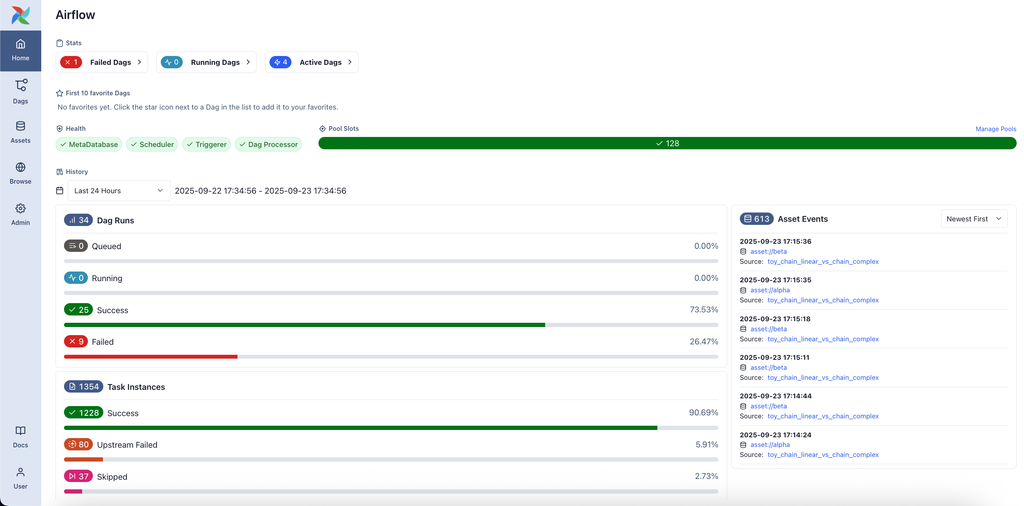
운영 환경에서는 컴포넌트를 개별적으로 분리해서 실행합니다.
airflow db migrate
airflow api-server --port 8080
airflow scheduler
airflow dag-processor
airflow triggerer   # deferrable 오퍼레이터 사용 시
작성한 DAG 파일은 $AIRFLOW_HOME/dags 폴더(또는 설정한 DAG 번들 경로)에 넣으면 DAG 프로세서가 자동으로 파싱해 UI와 스케줄러에 반영합니다. 실무 환경에서는 로컬 설치보다 Docker Compose나 공식 Helm Chart를 이용한 Kubernetes 배포, 또는 Astronomer·MWAA(AWS)·Cloud Composer(GCP) 같은 관리형 Airflow 서비스를 사용하는 경우가 많습니다.
프로젝트 활용 사례
Airflow는 “정해진 스케줄 또는 이벤트에 따라 여러 시스템을 넘나드는 작업들을 순서대로/조건부로 실행해야 하는” 거의 모든 데이터 파이프라인에 적용될 수 있습니다. 아래는 대표적인 활용 시나리오입니다(실제 구현 시 참고할 수 있는 구조 예시).
Case #1. 대형 이커머스 기업의 일일 매출 정산 및 데이터 웨어하우스(DW) 구축
- 문제: 수백 개의 물류센터·결제 게이트웨이·프로모션 시스템에서 발생하는 주문/환불/정산 데이터를 매일 새벽 집계해 재무팀과 BI 대시보드가 참조하는 DW(예: Snowflake, BigQuery, Redshift)에 적재해야 합니다.
- Airflow 적용: S3SensorOperator/GCSObjectExistenceSensor 등으로 원본 로그 도착을 감지 → SparkSubmitOperator나 TaskFlow 기반 Python 태스크로 정산 로직(환불 차감, 쿠폰 반영, 환율 변환)을 실행 →
dbt오퍼레이터로 웨어하우스 내 변환(transform) 모델 실행 → 마지막으로 Slack/이메일 알림 태스크로 완료 통보. - Airflow의 이점: TaskGroup으로 “채널별 정산” 로직을 시각적으로 그룹화하고, Backfill 기능으로 과거 특정 일자의 정산을 재처리할 수 있으며, Trigger Rule로 일부 채널이 실패해도 나머지 파이프라인은 계속 진행하도록 설계할 수 있습니다.
Case #2. 실시간 주식/코인 가격 변동 분석 및 커스텀 알림 서비스
- 문제: 초단위 시세 자체는 스트리밍(Kafka, Kinesis)이 담당하지만, “5분봉 이동평균 계산 후 임계값 초과 시 알림”, “장 마감 후 일간 리포트 생성” 같은 준실시간·배치성 분석 로직이 필요합니다.
- Airflow 적용: 짧은 주기(1~5분) 스케줄의 DAG로 최근 캔들 데이터를 조회 → Python 태스크에서 기술적 지표(RSI, MACD 등) 계산 → 조건 충족 시 BranchPythonOperator로 분기하여 알림 오퍼레이터(Slack, 푸시, 문자) 실행 → 장 마감 후 별도 스케줄의 DAG가 일간 리포트를 생성해 DW에 적재.
- Airflow의 이점: Sensor와 Deferrable Operator(Triggerer)를 활용하면 외부 API 응답 대기 중에도 워커 슬롯을 점유하지 않아 비용 효율적으로 다수의 종목/코인을 동시에 모니터링할 수 있습니다.
Case #3. AI 기반 의료 영상 분석 및 진단 데이터 파이프라인
- 문제: PACS(의료영상저장전송시스템)에 업로드된 CT/MRI 영상을 전처리(DICOM 변환, 정규화) 후 딥러닝 추론 서버에 전달하고, 결과를 의료진 검수 워크플로우와 EMR 시스템에 반영해야 합니다. 환자 데이터이므로 감사(audit) 추적과 재현성이 필수입니다.
- Airflow 적용: 신규 영상 도착 이벤트를 Sensor로 감지 → 전처리 오퍼레이터 → GPU 추론 작업은 KubernetesPodOperator로 격리된 컨테이너에서 실행 → 결과를 XCom이 아닌 오브젝트 스토리지에 저장(대용량 파일이므로) 후 경로만 XCom으로 전달 → 이상 소견 발견 시 담당 의료진에게 알림 태스크 트리거.
- Airflow의 이점: 모든 DAG 실행 이력과 코드가 버전 관리되므로 “어떤 모델 버전으로, 어떤 전처리 파라미터로 이 결과가 나왔는지” 추적이 가능해 규제 대응(FDA/식약처 등)에 유리하며, KubernetesExecutor로 GPU 리소스를 태스크 단위로 격리·오토스케일링할 수 있습니다.
Case #4. 자율주행 차량의 대규모 센서 데이터 학습 파이프라인
- 문제: 차량 플릿에서 수집되는 라이다/카메라/레이더 로그(하루 수십 TB)를 정제하고, 특정 시나리오(코너 케이스)를 마이닝해 모델 재학습용 데이터셋을 구성한 뒤, 분산 학습 클러스터에서 모델을 학습시키고 검증·배포까지 이어지는 MLOps 파이프라인이 필요합니다.
- Airflow 적용: 원시 로그 수집 완료를 Asset(구 Dataset) 기반 스케줄링으로 감지 → 대규모 병렬 전처리는 Dynamic Task Mapping으로 차량별/구간별 태스크를 런타임에 동적으로 생성 → Spark/Ray 클러스터에서 특징 추출 → 학습 잡을 Kubernetes 클러스터에 제출 → 검증 메트릭이 기준을 통과하면 자동으로 모델 레지스트리에 등록하고 스테이징 배포 태스크 실행.
- Airflow의 이점: Dynamic Task Mapping과 Asset 기반 스케줄링(데이터가 준비되는 즉시 다운스트림 DAG를 트리거)을 결합하면, “고정된 시간표”가 아니라 “데이터 준비 완료”를 기준으로 학습 파이프라인이 자동 연쇄 실행되는 이벤트 기반 MLOps 워크플로우를 구성할 수 있습니다.
유사한 데이터 워크플로우 플랫폼 비교 분석
| 플랫폼 | 정의 방식 | 강점 | 약점/차별점 |
|---|---|---|---|
| Apache Airflow | Python 코드(DAG) | 가장 큰 커뮤니티·프로바이더 생태계, 범용 오케스트레이션, 성숙한 UI | 스트리밍에는 부적합, 순수 배치 지향, 러닝커브 존재 |
| Prefect | Python 코드(데코레이터 중심) | 동적 워크플로우에 더 친화적인 API, 로컬 개발 경험 우수, 하이브리드 실행 모델 | 대규모 엔터프라이즈 사례·생태계는 Airflow 대비 상대적으로 적음 |
| Dagster | Python 코드(Asset 중심 선언형) | 데이터 자산(Asset) 중심 설계로 데이터 계보(lineage)·테스트 친화적, 강력한 타입 시스템 | 개념 모델이 Airflow와 달라 전환 비용 존재, 생태계 규모 상대적으로 작음 |
| Luigi | Python 코드(Task 중심, Spotify 개발) | 단순하고 가벼움 | UI·스케줄러 기능이 상대적으로 빈약, 최근 활발한 개발은 저조 |
| AWS Step Functions | JSON/ASL 선언형 (또는 Workflow Studio) | AWS 네이티브 서비스와의 깊은 통합, 서버리스 완전관리형 | 특정 클라우드에 종속(vendor lock-in), 복잡한 로직 작성이 상대적으로 번거로움 |
| Kubeflow Pipelines | Python SDK(컨테이너/컴포넌트 중심) | ML 파이프라인 및 Kubernetes 네이티브 환경에 특화 | 범용 데이터 오케스트레이션보다는 ML 워크로드에 초점, Kubernetes 의존성 높음 |
| dbt (+ 오케스트레이터) | SQL 기반 선언형 | 웨어하우스 내 변환(transform) 계보 관리에 특화 | 그 자체로는 오케스트레이터가 아니며 스케줄링을 위해 Airflow 등과 조합 필요 |
전반적으로 Airflow는 “범용성과 생태계 규모”에서 여전히 독보적인 위치에 있습니다. 반면 Dagster는 데이터 자산 중심의 선언적 설계로 데이터 리니지를 중요시하는 팀에서, Prefect는 더 가벼운 개발자 경험을 원하는 팀에서 대안으로 자주 언급됩니다. 클라우드 네이티브 환경에 완전히 종속되어도 괜찮다면 AWS Step Functions처럼 완전관리형 서비스도 선택지가 될 수 있으며, 이미 Kubernetes와 ML 워크로드 중심이라면 Kubeflow Pipelines가 더 적합할 수 있습니다. 다만 이 비교는 팀의 기존 기술 스택, 클라우드 전략, 조직의 Python 숙련도에 따라 결론이 달라질 수 있는 만큼 절대적인 우열이 있는 영역은 아닙니다.
결론
Apache Airflow는 “워크플로우를 코드로 정의한다”는 단순한 철학 위에, DAG·Task·Operator·Sensor·TaskFlow·Executor라는 명확한 개념 체계와 확장 가능한 아키텍처(스케줄러, DAG 프로세서, API 서버, 메타데이터 DB, 워커, 트리거러)를 쌓아올려 데이터 엔지니어링 표준 도구로 자리잡았습니다. 이커머스 정산, 실시간 시세 알림, 의료 AI 파이프라인, 자율주행 학습 파이프라인 등 이 글에서 살펴본 사례들의 공통점은 “여러 이질적인 시스템을 넘나들며, 의존성과 재시도·모니터링이 중요한 배치성 작업”이라는 점이며, 바로 이 지점이 Airflow가 가장 강력하게 힘을 발휘하는 영역입니다.
반면 완전한 실시간 스트리밍이 필요하거나, 코드보다 GUI 기반 저작을 선호하는 조직이라면 Prefect, Dagster, 혹은 클라우드 네이티브 서비스 같은 대안도 함께 검토해볼 가치가 있습니다. 결국 선택의 기준은 “팀이 Python과 코드 기반 워크플로우 관리에 얼마나 익숙한가”, 그리고 “오케스트레이션 대상이 배치 중심인가, 스트리밍 중심인가”에 달려 있습니다.
참고 링크
https://airflow.apache.org/docs/apache-airflow/stable/index.html
https://databoom.tistory.com/entry/Airflow-%EA%B0%9C%EC%9A%94
답글 남기기